Quanto custa cada pipeline? Sem essa conta, o corte é no escuro
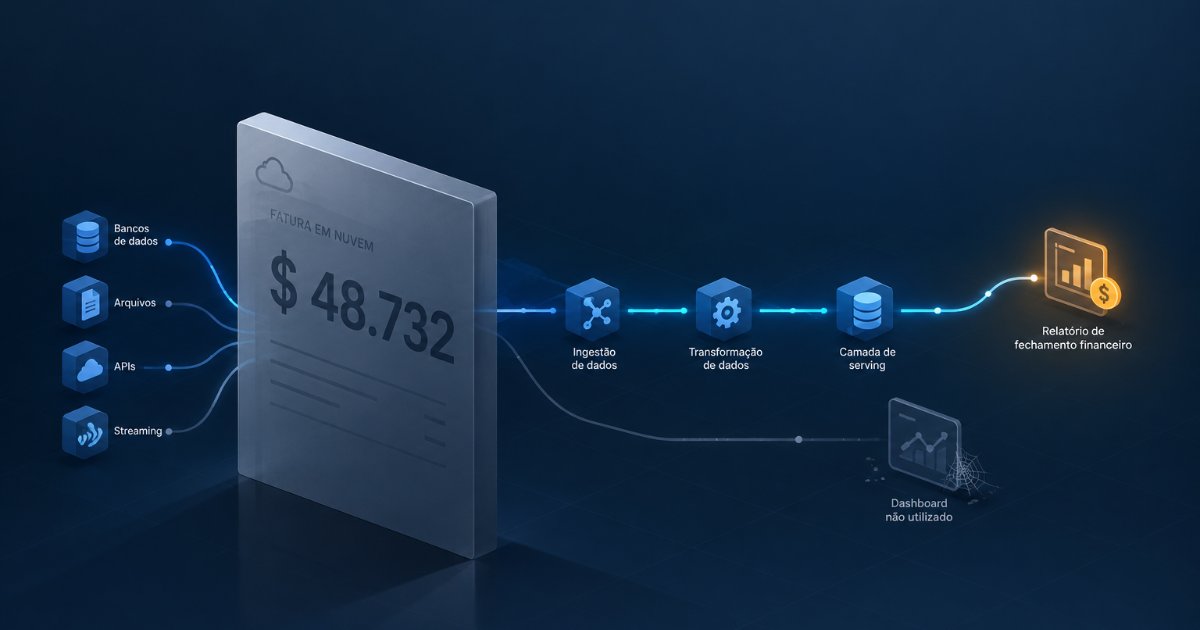
Custo por pipeline: a fatura da nuvem não sustenta sozinha a decisão de corte. Quando a fatura da nuvem sobe, o pedido costuma chegar rápido: cortar. A fatura mostra quanto se gastou, mas não mostra o que cada gasto sustenta. Sem essa ligação, a equipe de dados tende a mexer no que é mais fácil, e não no que pesa menos para o negócio.
Um pipeline caro pode alimentar o fechamento financeiro ou a conciliação diária. Um pipeline barato pode atualizar toda madrugada um relatório que ninguém abre há meses. No total da fatura, os dois aparecem do mesmo jeito: como linhas de consumo dentro de um único número.
O total da nuvem esconde a pergunta certa. A Jump resume bem o problema: uma empresa pode saber quanto gastou em nuvem no mês e, mesmo assim, não saber quanto custa um pipeline específico ou uma execução que falhou. O painel do provedor organiza o gasto por serviço, conta ou região. Atribuir esse gasto a um processo de negócio é possível. GCP, AWS e Azure permitem rateio por labels e tags, mas isso só existe quando os recursos estão etiquetados com disciplina. E é exatamente aí que a maioria das operações falha: o gargalo é a marcação, não a ferramenta.
O guia de otimização de custos do Google Cloud para serviços financeiros pergunta se o valor gasto em um pipeline de análise de dados está gerando valor comercial. Essa pergunta só tem resposta quando o custo está atribuído ao pipeline.
Quatro medidas que tornam o custo comparável:
-
O custo por pipeline, ou seja, quanto cada fluxo consome por mês em processamento, armazenamento e movimentação de dados: A Objective inclui o custo por pipeline e por dataset entre os indicadores financeiros que uma prática de Data FinOps deve acompanhar de perto. É a granularidade mínima: sem ela, o FinOps fica no nível de conta e nunca chega ao produto de dados.
-
O custo por execução: mostra se o gasto vem do desenho do pipeline ou da frequência com que ele roda. Quando um fluxo atualiza a cada hora um dado consultado uma vez por semana, o problema está no agendamento, e não na tecnologia.
-
O custo por GB processado: com ele, dá para comparar pipelines de tamanhos diferentes e perceber quando um fluxo processa muito mais do que precisa, como ao recarregar tabelas inteiras em vez de carregar só o que mudou. Mas convém ler esse número com cuidado: ele compara volume, não eficiência. Dois pipelines que processam 1 TB podem ter custo por GB muito diferente por causa de tempo ocioso de slot, shuffle e reprocessamento.
-
O custo por GB útil entregue: o volume processado dividido pelo volume efetivamente materializado e consumido. É ela que separa o pipeline que processa muito do pipeline que processa mal. Um fluxo que lê 10 TB para publicar 200 MB de saída tem um problema de desenho que o custo por GB processado, sozinho, não revela.
Para chegar a esses números, cada gasto precisa ser rastreável até o pipeline que o gerou. Isso exige etiquetar os recursos, separar os ambientes e cruzar a fatura com os registros de execução do orquestrador. Sem essa marcação, qualquer rateio é só uma estimativa. O caminho mais direto, quando o provedor oferece, é usar o custo no nível de job, como o custo por job do BigQuery ou o custo por execução com tags no Glue, porque ele dispensa rateio e liga o gasto diretamente à execução no orquestrador. Chamamos esse conjunto de práticas de cost attribution, e é o que separa um dashboard de custo de uma prática real de Data FinOps.
Custo sozinho não decide nada.
Saber que um pipeline custa caro não diz se ele deve ser cortado. A DataEX lembra que, sem informação clara sobre o uso, não há base para decidir o que otimizar. Ela aponta os produtos de dados como uma forma de ligar o consumo ao valor e de definir quem responde por cada carga.
O uso real aparece em quem consulta o dado e com que frequência, em quais painéis ou modelos dependem dele e em quais processos param se ele atrasar. A Eleflow sugere monitorar os acessos para identificar dados inativos. Colocada ao lado do custo, essa informação forma um mapa simples:
Caro e muito usado: o caminho é otimizar (ajustar a frequência, adotar carga incremental, revisar consultas), e não desligar. Caro e pouco usado: pede uma conversa com o dono do dado antes de qualquer decisão. Barato e sem uso: é candidato a desligar, desde que não haja obrigação regulatória ou de auditoria por trás. Barato e muito usado: em geral, fica como está. Esse mapa ganha precisão com um terceiro eixo: a criticidade. Um pipeline caro e pouco usado pode ser o fechamento contábil mensal, que só roda em dias específicos. Um pipeline barato e sem acessos pode ser uma trilha de auditoria exigida por regulação. Sem essa dimensão, a matriz custo × uso corta o que é pequeno e necessário, e mantém o que é grande e inútil. Na prática, a decisão é sempre risco × custo × valor, nunca custo × uso isoladamente.
Antes de desligar, confirmar com quem usa. Um relatório sem acessos recentes pode ser sazonal, como os de fechamento trimestral ou anual. Por isso, a decisão de desligar deve passar pelo responsável da área que consome o dado, e não só pela equipe de dados.
Uma prática prudente é pausar antes de apagar: suspender a execução, avisar os consumidores conhecidos e observar se alguém sente falta. Esse desligamento reversível reduz o risco de quebrar um processo em silêncio e é padrão em governança de dados madura. Se ninguém se manifestar, o desligamento se confirma com menos risco.
Também vale procurar duplicidades. A DataEX aponta os vários pipelines que processam os mesmos dados com pequenas variações como um dos desperdícios mais recorrentes, e frequentemente subestimados, em plataformas analíticas. São os chamados shadow pipelines, cópias criadas por área que ninguém enxerga no inventário. Juntar esses fluxos pode render mais do que otimizar cada um separadamente.
Por onde começar. O primeiro passo é escolher os pipelines que mais pesam na fatura e calcular, para cada um, o custo mensal, o custo por execução e o volume processado. Depois, levantar quem consome cada saída, com que frequência e qual o impacto de uma eventual interrupção. Com custo, uso e criticidade lado a lado, a lista de cortes passa a ter critério.
A Financeit atua na estruturação de dados, com integração e governança, e pode apoiar o mapeamento dos pipelines, a atribuição de custos e a decisão sobre o que manter, otimizar ou desligar. Na prática, isso se materializa em um Cost Attribution Blueprint: um esquema de labels padronizado, as consultas de rateio entre fatura e execução e um painel de custo por pipeline com o eixo de uso. Uma boa forma de começar é fazer o exercício com poucos fluxos e ampliar a análise depois.